Bioinformatics Research In Disease Genomics (BRIDGe)
Équipe 4
Mots-clés : Génomique, Relation gène-enhancer, Variants structurels, Pangénome.
Programme de recherche
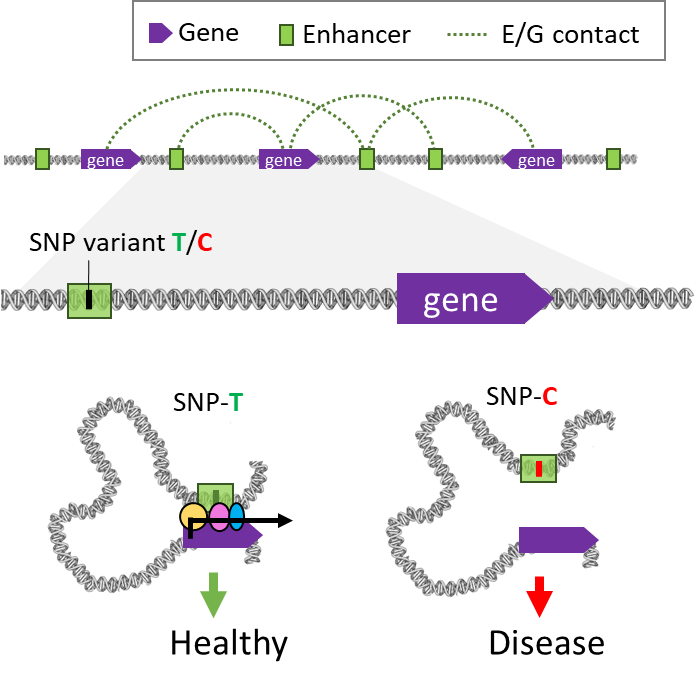
L’équipe Bioinformatics Research In Disease Genomics (BRIDGe) étudie l’impact fonctionnel des variations génomiques sur les maladies. Bien que notre recherche soit fondamentalement sans a priori hypothétique, notre objectif est d’appliquer nos méthodes et analyses en priorité aux maladies digestives étudiées au sein du laboratoire, afin de tirer parti de l’expertise locale et de valider nos résultats.
Bien que de nombreuses études d’association pangénomiques (GWAS) aient identifié des milliers de variants associés à des maladies courantes, deux problèmes majeurs entravent une compréhension approfondie des mécanismes biologiques sous-jacents à ces maladies et le développement de nouveaux traitements :
- les variants causaux réels restent très souvent inconnus,
- l’ensemble des variants identifiés n’explique pas entièrement l’héritabilité de la maladie. En réalité, ces deux problèmes découlent du fait que :
- seuls les petits variants (SNP) sont testés pour leur association avec la maladie,
- la grande majorité des variants associés sont situés dans des régions régulatrices non codantes du génome.
Pour ces raisons, nous concentrons nos efforts sur :
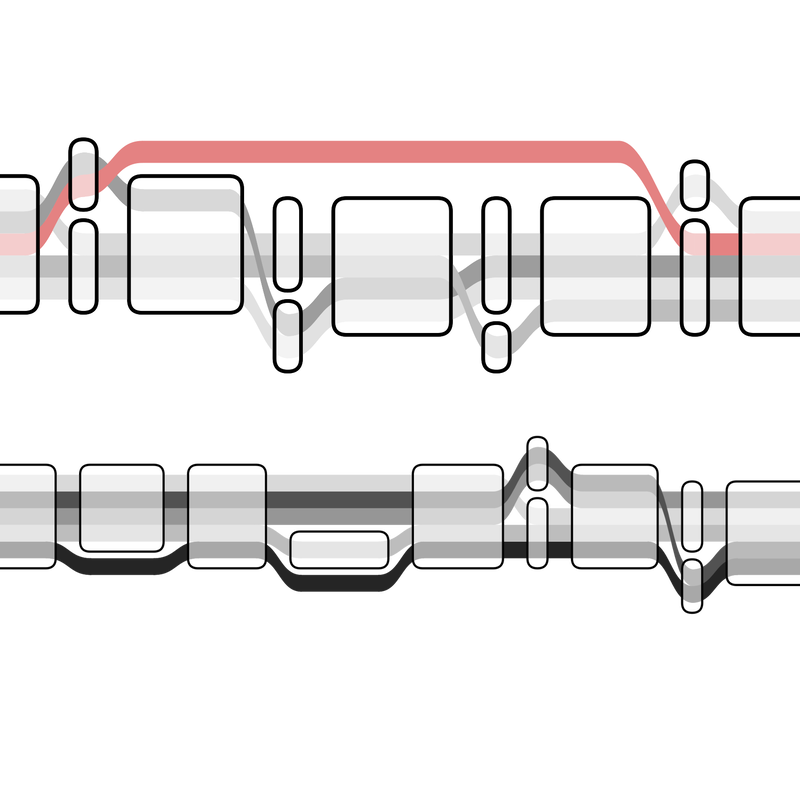
- L’extension des études d’association à des variants plus longs et complexes, tels que les variants structurels (SV, comme les duplications, délétions, insertions et translocations), en utilisant des approches pangénomiques ;
- La dérivation d’annotations fonctionnelles génomiques spécifiques à des types cellulaires et leur intégration dans les études sur les maladies ;
- L’intégration des variants structurels et des annotations fonctionnelles pour améliorer le diagnostic moléculaire dans les études sur les maladies génétiques rares.
Membres
Anciens membres
Outils et méthodes
- Analyse de séquençage du transcriptome (RNA-seq, miRNA-seq)
- Analyse de la conformation 3D de l’ADN (Hi-C, promoter capture Hi-C)
- Méthodes multi-omiques intégratives (ex. : mixOmics)
- Analyse de séquençage du génome à partir de données de lectures courtes (Illumina) ou longues (Oxford Nanopore)
- Analyse de données de séquençage utilisant des pangénomes humains (construction de pangénomes, alignement de lectures, appel de variants)
- Tests d’association pangénomique (GWAS)
- Appel de variants pour les maladies rares à partir de données de lectures longues (assemblage de novo phasé, variants structurels, annotation), y compris pour les régions complexes (ex. : module RCCX)
Les membres de l’équipe ont contribué à plusieurs logiciels publics, dont certains sont mis en avant ci-dessous :
- ChimPipe : un outil pour détecter de nouveaux transcrits chimériques et gènes de fusion à partir de données RNA-seq (Rodríguez-Martín et al. BMC Genomics 2017).
- TAGADA : un pipeline complet pour l’analyse RNA-seq, incluant des modules pour créer des annotations de transcrits novateurs et quantifier l’expression des gènes et des transcrits (Kurylo, Guyomar, Foissac et Djebali. NAR Genomics and Bioinformatics 2023).
- PaintorPipe : un pipeline pour réaliser des analyses de fine-mapping des résultats de GWAS en utilisant diverses annotations fonctionnelles (Gerber et al. Bioinformatics Advances 2024).
- sveval : un package R pour manipuler et évaluer les performances des variants structurels (Hickey, Heller, Monlong et al. Genome Biology 2020).
- vg : une boîte à outils pour manipuler des pangénomes et analyser des données de séquençage, incluant l’alignement rapide de lectures Giraffe (Sirén, Monlong, Chang, Novak, Eizenga et al. Science 2021).
- Minigraph-Cactus : un pipeline de construction de pangénomes à partir d’assemblages génomiques de haute qualité (Hickey, Monlong et al. Nature Biotechnology 2024).
- Parakit : un outil basé sur le pangénome pour caractériser le module complexe RCCX à partir de données de lectures longues (Monlong et al. medRxiv 2025).
Recruitement
Nous sommes activement à la recherche de nouveaux membres pour élargir notre équipe et accueillons avec enthousiasme des chercheurs en génomique et bioinformatique. Certains projets pourraient bénéficier de nouvelles expertises, notamment :
- des compétences avancées en statistiques pour contribuer à l’imputation de variants ;
- des connaissances en transcriptomique monocellulaire pour enrichir notre caractérisation cellulaire spécifique de la régulation des gènes ;
- ou encore des compétences en apprentissage automatique (machine learning) pour aider à prédire les éléments fonctionnels du génome ou les variants non codants fonctionnels.
Des recherches complémentaires pourraient également inclure des approches intégrant davantage de variants (par exemple, les variants structurels) ou des variants dotés de meilleures annotations fonctionnelles (par exemple, dans les régions régulatrices spécifiques à certaines cellules). Cela pourrait concerner, entre autres, le développement de métriques évolutives plus fines ou de scores de risque polygéniques.
N’hésitez pas à contacter Sarah et Jean si vous êtes intéressé(e) par une collaboration au sein de notre équipe !
Publications
HPRC2: A human pangenome reference with near-complete coverage of common genetic variation. Julian Lucas, Prajna Hebbar, ..., Jean Monlong, et al., bioRxiv 2026. DOI: 10.64898/2026.07.21.739710
Advancing long-read nanopore genome assembly and accurate variant calling for rare disease detection. Shloka Negi, Sarah L. Stenton, ..., Jean Monlong, et al., The American Journal of Human Genetics 2025. DOI: 10.1016/j.ajhg.2025.01.002
Differences in maternal diet fiber content influence patterns of gene expression and chromatin accessibility in fetuses and piglets. Smahane Chalabi, Linda M. P. Loonen, ..., Sarah Djebali, et al., Genomics 2025. DOI: 10.1016/j.ygeno.2025.110995
Polygenic risk score prediction accuracy convergence. Léo Henches, Jihye Kim, ..., Arthur Frouin, ..., Sarah Djebali, et al., Human Genetics and Genomics Advances 2025. DOI: 10.1016/j.xhgg.2025.100457
Long-read sequencing resolves the clinically relevant *CYP21A2* locus, supporting a new clinical test for Congenital Adrenal Hyperplasia. Jean Monlong, Xiao Chen, et al., medRxiv 2025. DOI: 10.1101/2025.02.07.25321404
Efficient indexing and querying of annotations in a pangenome graph. Adam M. Novak, Dickson Chung, ..., Sarah Djebali, ..., Jean Monlong, bioRxiv 2024. DOI: 10.1101/2024.10.12.618009
TAGADA: a scalable pipeline to improve genome annotations with RNA-seq data. Cyril Kurylo, Cervin Guyomar, ..., Sarah Djebali, NAR Genomics and Bioinformatics 2023. DOI: 10.1093/nargab/lqad089
Enhancer/gene relationships: Need for more reliable genome-wide reference sets. Tristan Hoellinger, Camille Mestre, ..., Sarah Djebali, Frontiers in Bioinformatics 2023. DOI: 10.3389/fbinf.2023.1092853
PaintorPipe: a pipeline for genetic variant fine-mapping using functional annotations. Zoé Gerber, Michel Fisun, ..., Sarah Djebali, Bioinformatics Advances 2023. DOI: 10.1093/bioadv/vbad188
A Bos taurus sequencing methods benchmark for assembly, haplotyping, and variant calling. Camille Eché, Carole Iampietro, ..., Sarah Djebali, et al., Scientific Data 2023. DOI: 10.1038/s41597-023-02249-1
A draft human pangenome reference. Wen‐Wei Liao, Mobin Asri, ..., Jean Monlong, et al., Nature 2023. DOI: 10.1038/s41586-023-05896-x
Pangenome graph construction from genome alignments with Minigraph-Cactus. Glenn Hickey, Jean Monlong, et al., Nature Biotechnology 2023. DOI: 10.1038/s41587-023-01793-w
Scalable Nanopore sequencing of human genomes provides a comprehensive view of haplotype-resolved variation and methylation. Mikhail Kolmogorov, Kimberley J. Billingsley, ..., Jean Monlong, et al., Nature Methods 2023. DOI: 10.1038/s41592-023-01993-x
Pangenomics enables genotyping of known structural variants in 5202 diverse genomes. Jouni Sirén, Jean Monlong, et al., Science 2021. DOI: 10.1126/science.abg8871
Expanded encyclopaedias of DNA elements in the human and mouse genomes. Federico Abascal, Reyes Acosta, ..., Sarah Djebali, et al., Nature 2020. DOI: 10.1038/s41586-020-2493-4
Multi-species annotation of transcriptome and chromatin structure in domesticated animals. Sylvain Foissac, Sarah Djebali, et al., BMC Biology 2019. DOI: 10.1186/s12915-019-0726-5
Exploring the phenotypic consequences of tissue specific gene expression variation inferred from GWAS summary statistics. Alvaro Barbeira, Scott Dickinson, ..., Jean Monlong, et al., Nature Communications 2018. DOI: 10.1038/s41467-018-03621-1
An atlas of human long non-coding RNAs with accurate 5′ ends. Chung-Chau Hon, Jordan A. Ramilowski, ..., Sarah Djebali, et al., Nature 2017. DOI: 10.1038/nature21374